MiniMax H3 强袭开源教程
MiniMax H3 强袭开源教程
马老师MiniMax H3 正式开源:最低 8G 显存也能跑?我把部署和实测坑位都踩了一遍
这两年我折腾过的开源视频模型不算少,老实讲大部分最后都被我删了。
原因通常就俩:
- 模型太大:普通电脑根本跑不动
- 能跑起来:画面一言难尽,人物一动就崩;声音还得自己后期配
但这次 MiniMax 开源的 H3,确实让我有点意外:它不是“画面多电影感”那种单点强,而是可控性做得很完整——文本、图像、视频、音频、角色参考、镜头运动,甚至语音克隆,都能塞进同一套工作流里跑。
如果你想做广告片、音乐视频、品牌素材、游戏过场动画,这种控制精度,属于“开源往前迈了一大步”。
一、H3 到底是什么?(先把定位讲清楚)
H3 是 MiniMax 在 8 月 3 日正式开源的 全模态生成系统,不只是“文生视频”。
官方描述是:它能统一理解由 文本 / 图像 / 视频 / 音频构成的多模态上下文,然后直接生成带原生立体声的视频。
我把文章里最关键的能力点整理成一张清单(方便你快速判断值不值得折腾):
- 输出时长:4–15 秒
- 分辨率:最高 2K
- 音画:同步生成(32kHz 立体声),不是后期贴音轨
- 口型与语音:支持中、英、日、韩、法等 11 种语言
- 榜单表现:Artificial Analysis 上,H3 的视频编辑能力排名第一;文生视频、图生视频分别位列第二、第三(原文描述)
另外一点:它是海螺 AI(Hailuo)体系的第三代视频模型,架构换成了 H3-Context-IR,和 Hailuo 01/02 不是一套东西。

原文里还提到“越狱版已公布,限制更少”。这类内容我建议大家自行评估合规与风险,本文重点放在部署与跑通。


二、显存到底要多少?(这段请认真看)
网上现在满天飞“8G 显存也能跑”。我把原文里提到的公开实测/验证配置,按“能稳定跑通”到“官方验证”梳理一下,你自己判断期望值:
1)已有稳定跑通记录(相对现实)
- 12G 显存 + 32G 内存 + 高速固态(NVMe 更稳)
- 实测:生成 5 秒 480p,20 步,接近 5 分钟
2)官方未量化版本的公开验证(离家用较远)
- 双卡:每张 32G 显存(合计 64G)
- 系统内存约 384G
- 生成:5 秒 1344×768,50 步,约 9.3 分钟
3)为什么 12G 能跑动 40G+ 的模型?
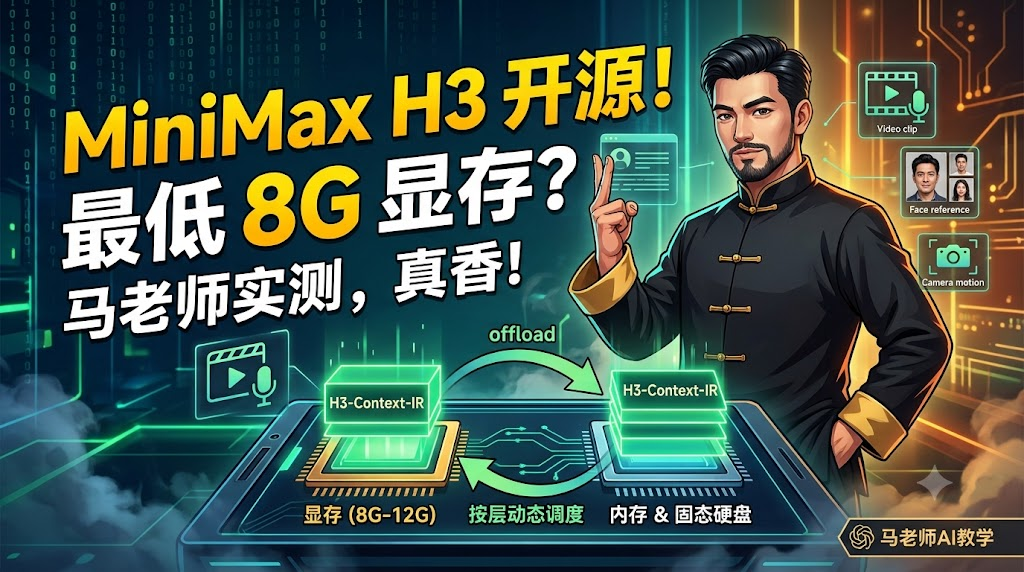
核心原因是 ComfyUI 的 按层动态调度(offload):需要哪一层就把哪一层搬进显存,其余留在内存和硬盘里。
所以显存不够一般不会直接报错——它会变慢。
4)那 8G 能不能跑?
能,但得靠更激进的量化(Q2/Q3)+ 大量 offload,出片时间会明显拉长,且低量化对画质的损伤是客观存在的。
如果你是 8G 卡,我给个“更像能跑通”的起手式(原文建议):
- 内存:32G 起步
- 硬盘:NVMe 固态
- 参数:从 480p / 20 步 / 5 秒开始
- 别上来就冲 720p,更别说 2K
三、开始部署(按这个顺序来,少踩坑)
第一步:升级 ComfyUI(必须)
H3 需要 ComfyUI 0.27 或更高版本,老版本没有对应的原生节点。
- 官方下载: https://comfy.org/
- 备用下载(原文提供,含越狱工作流及节点):https://pan.quark.cn/s/0983155437cb
如果你之前装的是 ComfyUI 桌面版,务必升级到最新版;用整合包/启动器的,就用“更新”功能更新,然后启动一次在右下角确认版本号。
第二步:选择模型类型
原文提到模板中心有 3 种开源模型方向:
- 文生视频
- 图生视频
- 视频转视频

建议你先把分辨率设小一点,先跑通再说;等生成完成后再考虑放大到 1080p/2K/4K。
原文提供的“视频高清放大工具”下载:

第三步:关于“越狱模型”(按需)
原文提供的下载入口如下(我原样保留链接):
- HuggingFace(含 ComfyUI INT8 工作流相关):
https://huggingface.co/ethanfel/Qwen3-VL-32B-Ultra-Heretic-MiniMax-H3-ComfyUI-INT8-ConvRot/tree/main - 备用整合包:
https://git.cloudeop.com/repo.php?id=afff7d33
原文说越狱模型有 3 个版本,其中 47.97G BF16 满血版更吃显存;消费级建议选更小的量化模型(如 24.55G 量化版)。
另有一个更小的量化版(原文标注“适合 8G 显存”):
- HuggingFace:https://huggingface.co/lilcheaty/MiniMax-H3-NVFP4
- 备用整合包:https://git.cloudeop.com/repo.php?id=f038f329
第四步:工作流与节点(建议直接用现成的)
- 越狱工作流节点(GitHub):https://github.com/ethanfel/ComfyUI-MiniMax-H3-Guide
- 备用节点下载:https://pan.quark.cn/s/0be892574480
- 工作流文件:https://pan.quark.cn/s/72e594594337
- 备用工作流:https://pan.cloudeop.com/s/2169A9B70792D8B7
四、模型文件放置目录(别放错,不然必报错)
原文给了一个很关键的“类型—目录”表,我这里用清单方式复述(路径原样保留):
模型介绍
| 类型 | 文件 | 放置目录 |
|---|---|---|
| 主模型 | MiniMax-H3-FL2VA-Q4_K_M.gguf(按显存选量化) | models/unet/ |
| 文本编码器 | qwen3vl_32b_minimax_h3_Q4_K_M.gguf | models/text_encoders/ |
| 视频 VAE | minimax_h3_video_vae_fp16.safetensors | models/vae/ |
| 音频 VAE | minimax_h3_audio_vae_fp32.safetensors | models/vae/ |
量化版本怎么选(原文建议)
- 24G 及以上:Q8 或官方 INT8 / NVFP4
- 16G:Q5 或 Q4
- 12G:Q4
- 8G:Q3,或混合精度 Q2
重要坑位(请划重点):音频 VAE 必须是 fp32。
用 fp16 容易出现音画不同步,甚至没声音(原文踩坑提示)。
另外,走官方原生路线的同学注意:权重需要同时放在两个目录(原文强调“缺一个都会报错”):
models/MiniMax-H3/(单文件权重)models/diffusers/MiniMax-H3/(分片版本,含 config.json)
五、加载工作流 & 第一次生成(跑通标准化流程)
1)加载工作流
- GGUF 仓库一般会附带工作流 JSON(例如
MiniMax FL2V GGUF (WORKFLOW).json),下载后拖进 ComfyUI 即可。 - 官方原生路线:模板浏览器内置 H3 官方工作流,直接选。
2)加载后先检查 4 个节点(变绿再点生成)
- Unet Loader (GGUF):选择主模型
- CLIP Loader (GGUF):选择 qwen3vl 文本编码器
- VAE Loader:视频 VAE / 音频 VAE 两个,别接反
- 分辨率与时长:第一次建议 480p、5 秒
3)第一次跑慢是正常的
第一次会把权重从硬盘加载进来。8G–12G 显存机器,5 秒 480p、20 步,心理预期大概 8–15 分钟(原文范围)。
第二次会快很多,因为部分权重已经缓存在内存里。
六、实测体验:怎么把片子拍好看(提示词技巧)
跑通只是入门,真正决定出片质量的是提示词。H3 有个特点:它真的能听懂“镜头语言”。
1)提示词要写“分镜”,不要写“标签”
过去 SD 那套“关键词堆砌”,在 H3 上效果一般。H3 更吃完整场景描述 + 镜头调度。
不好的写法(原文示例):
1 | 一个女人,咖啡馆,下雨,电影感,8k,高质量 |
好的写法(原文示例):
1 | 黄昏的咖啡馆靠窗位置,窗外下着小雨。一位穿米色针织衫的女性 |
差别在于:第二种把画面、动作、运镜、光线、声音都交代清楚了。H3 的音频是跟画面一起生成的——你不写声音,它就会自己猜,往往不如你预期。
2)镜头运动可以直接用术语
推、拉、摇、移、跟、升降,H3 都认。英文也可以:dolly in / pan left / crane shot / handheld。
3)角色一致性:靠 Ref2VA
Ref2VA 分区可以喂同一个角色的多张参考图(最多 9 张,建议 3–5 张不同角度),再配语音参考,就能做出跨镜头一致的人物与声音。
经验:参考图质量比数量重要。5 张清晰正侧面照,胜过 9 张糊图。
4)15 秒不够:尾帧接首帧
单次最长 15 秒是硬限制。想做长片就用“尾帧接首帧”串起来:第一段最后一帧导出作为第二段首帧输入,再配合 Ref2VA 锁角色。
七、常见问题排查(对着抄就行)
- 报错找不到节点:ComfyUI 版本太老,或没装 ComfyUI-GGUF
- 加载模型爆显存:换更低量化;启动参数加
--lowvram - 生成没声音:音频 VAE 是否 fp32(必须)
- 音画不同步:视频/音频 VAE 是否接反
- 速度慢到离谱:模型是否在固态硬盘;机械盘会让 offload 慢很多;同时确认内存是否足够(不够会走虚拟内存,更慢)
- 画面崩坏/人物变形:量化太狠(Q2/Q3 画质损伤客观存在);要么加显存,要么降分辨率换质量
总结:这次开源的意义到底在哪?
我更认同原文的判断:意义不在于“又多了一个能跑的模型”,而在于——开源视频模型第一次在可控性上,逼近甚至追平了部分闭源产品。
音画同步生成、跨镜头角色一致、镜头语言可控、11 种语言口型……这些在半年前还是闭源产品的护城河,现在权重就能落在你硬盘里。
门槛当然还在:12G 显存是相对舒服的起点;8G 能跑,但需要耐心和取舍。不过考虑到开源第一周,量化与推理优化迭代通常很快,再过一两个月体验大概率会更友好。
总结
H3 这次开源的意义,我觉得不在于”又多了一个能跑的模型”,而在于开源视频模型第一次在可控性上追平了闭源产品。
- AD -
音画同步生成、角色跨镜头一致、镜头语言可控、11 种语言口型,这些能力放在半年前还是闭源产品的护城河,现在权重就在你硬盘里。
配置门槛确实还在。12G 显存是目前比较舒服的起点,8G 能跑但需要耐心。但考虑到这才是开源第一周,量化方案和推理优化的迭代速度一向很快,再过一两个月的情况大概率会更好。
想玩的现在就可以动手了。有问题欢迎在评论区交流,我看到都会回。